Banco de trabajo de datos e IA
Inteligencia de datos
que puedes verificar.
En tu nube, con tus modelos, con tus reglas, y cada respuesta enseña su trabajo: el SQL que ejecutó, las tablas que leyó y los fragmentos que citó.
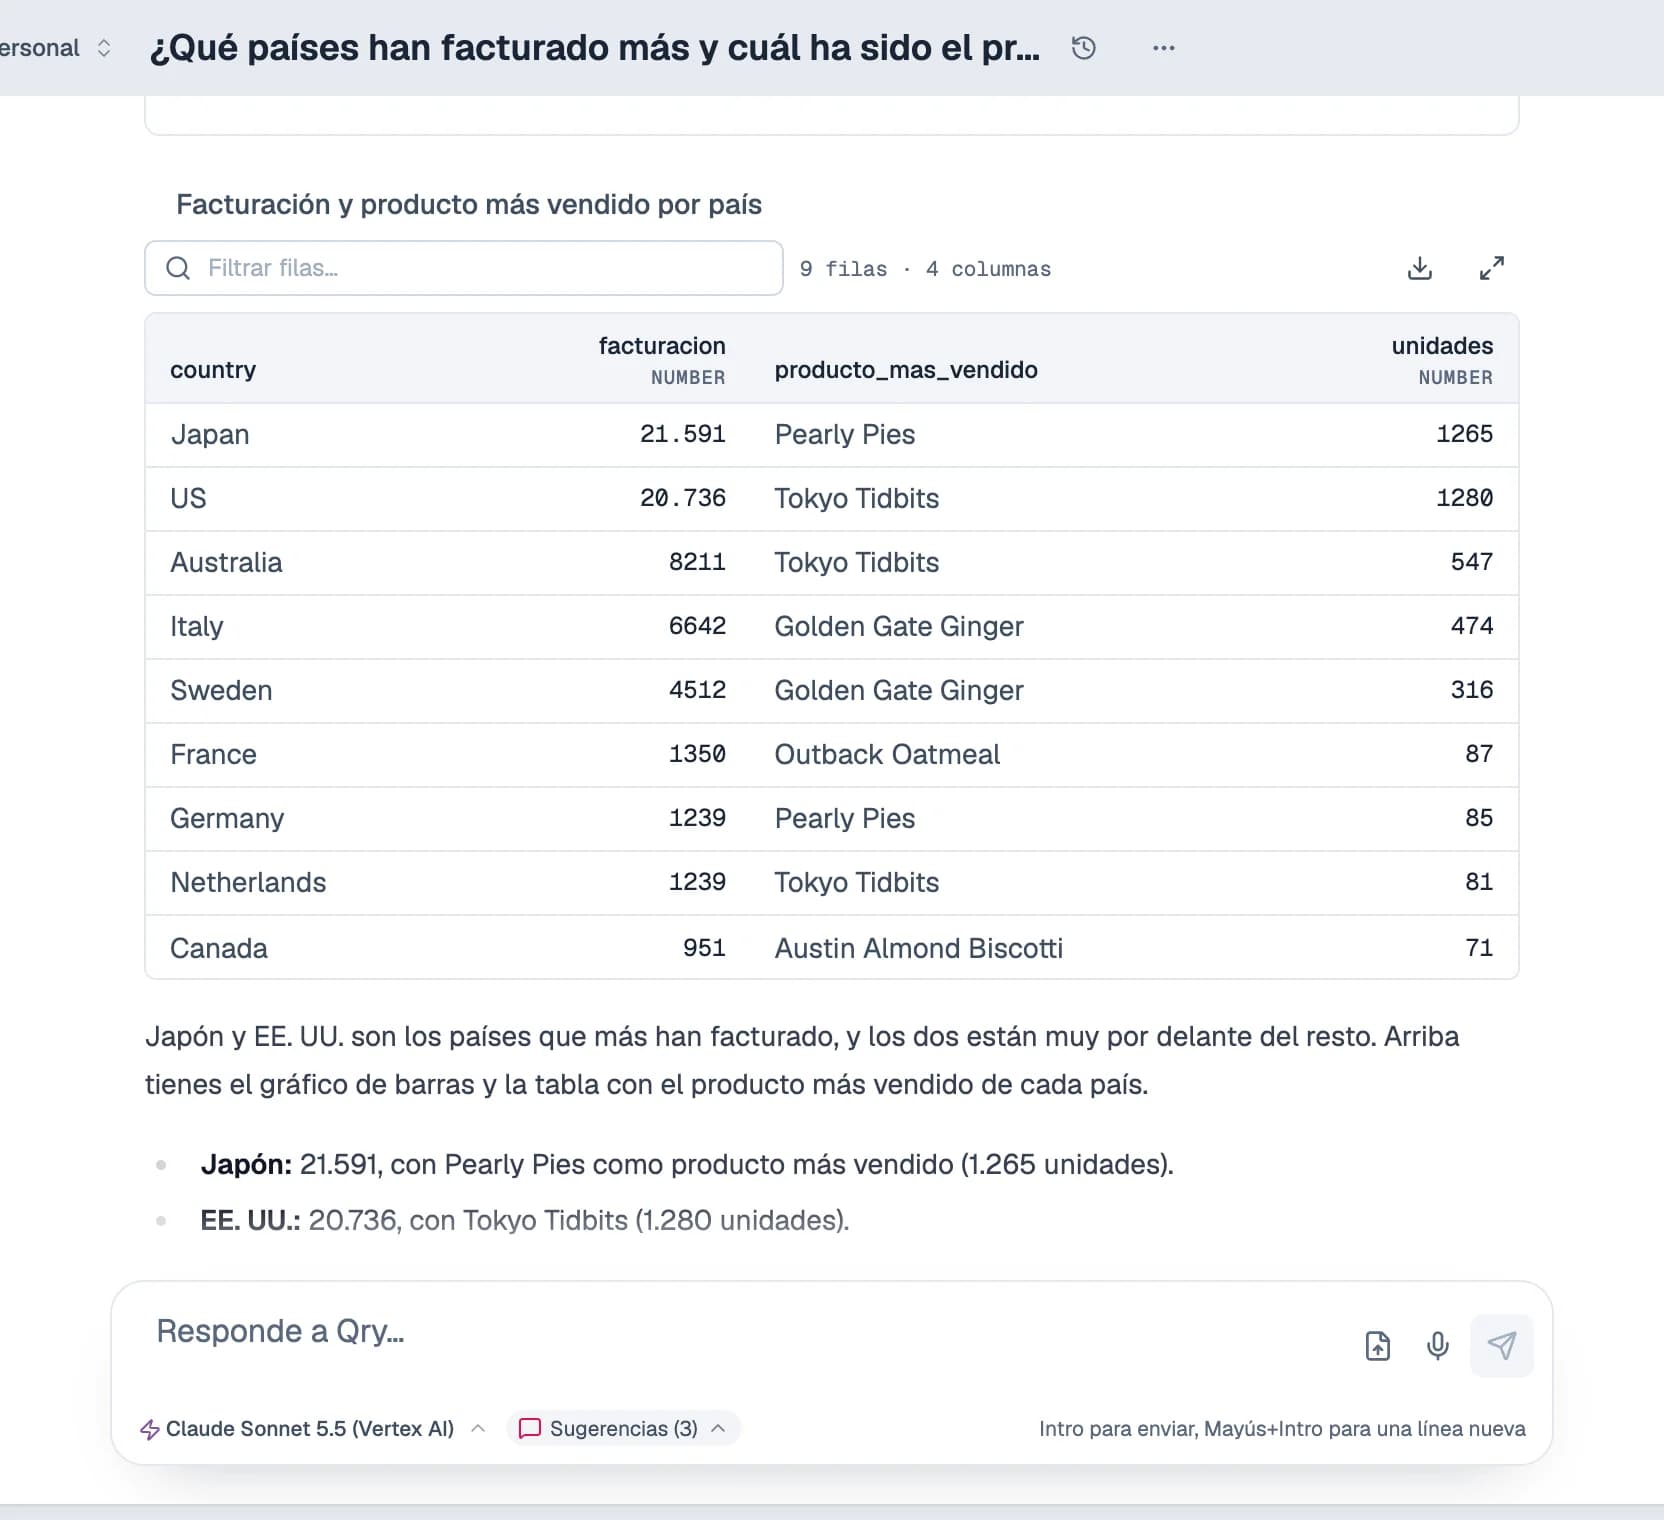
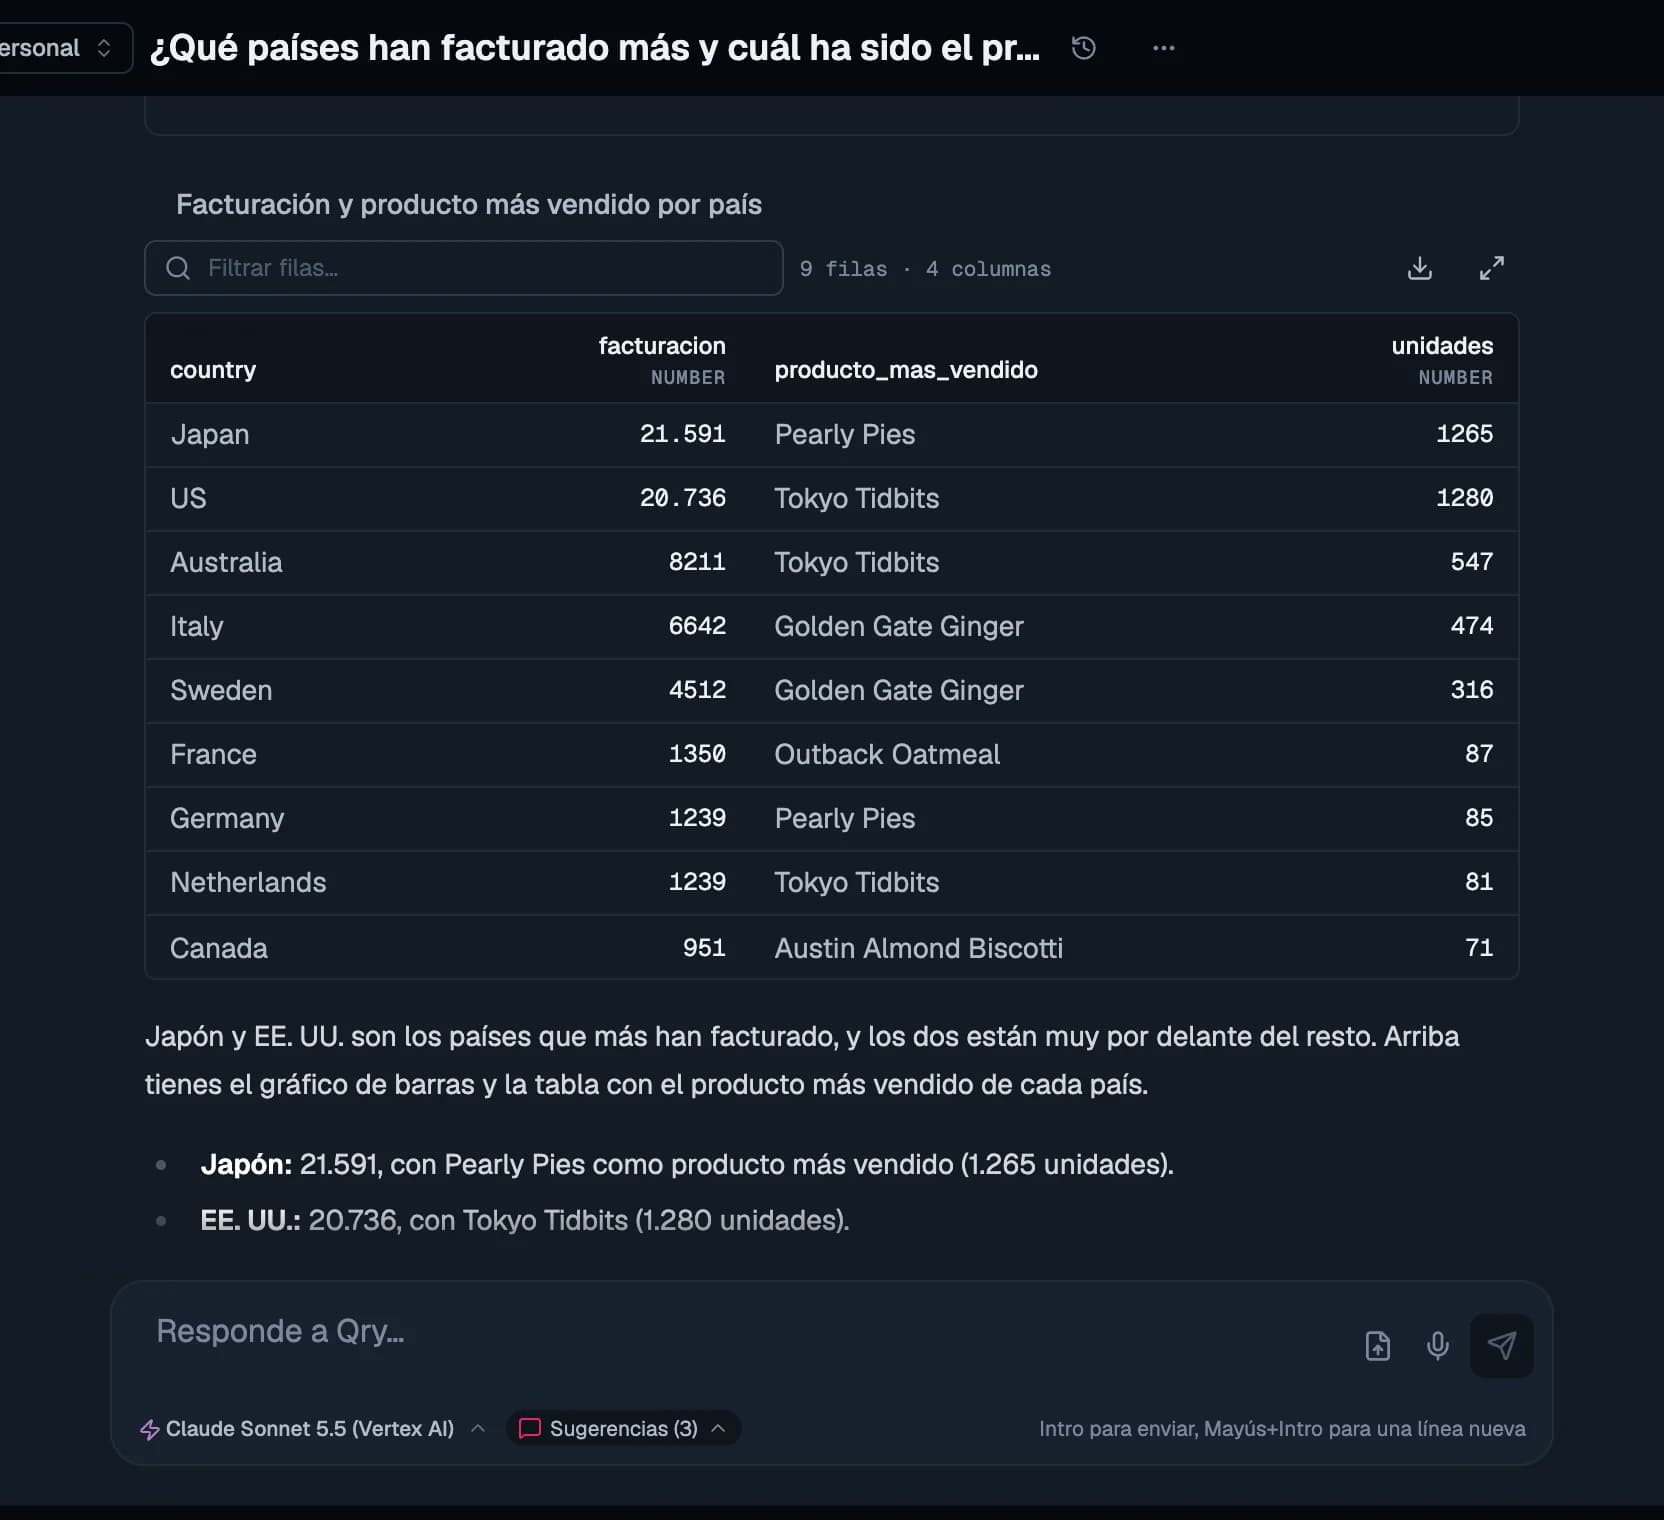
¿Qué países han facturado más? — Japón y EE. UU. suman el 63 % de la facturación, muy por delante del resto.
01
Verificable
Cada respuesta lleva su SQL, y se señala cualquier cifra que los datos no respalden. Las migraciones se demuestran ejecutando los dos lados; las reglas avisan cuando caducan.
02
Soberana
Tu instalación y tu base de datos. Claude, GPT o Gemini con tus propios contratos, o un modelo que alojes tú. Interfaz en español e inglés.
03
Gobernada
Qry actúa como la persona que pregunta: sus permisos y sus filtros de fila, en cada consulta y hasta la fila.
Medido, no prometido
Mismas preguntas, mismos datos, lado a lado
Qry frente al asistente de IA integrado de una plataforma de datos líder, sobre el mismo warehouse y con las mismas preguntas.
- Preguntas habituales bien respondidas
- Qry: 31 / 31Asistente integrado: 29 / 31
- Preguntas difíciles bien respondidas
- Qry: 5 / 5Asistente integrado: 1 / 5
- Tiempo mediano de respuesta (menos es mejor)
- Qry: 8 sAsistente integrado: 14 s
Conjuntos de datos públicos de ejemplo (TPC-H y uno de ventas), el mismo warehouse, ninguno con instrucciones ni skills. Octubre de 2026.
La diferencia es de método. El otro asistente supuso los valores al escribir el SQL: buscó «approved» donde los datos dicen «Y». Qry mira los datos antes, y pasa a Python cuando una pregunta necesita estadística.
Con otra familia de modelos —GPT a través de Azure AI Foundry, en la UE— Qry también respondió 31 de 31 y 5 de 5. El acierto no depende de un proveedor.
Cada cambio de modelo, prompt o skill se mide contra un banco de preguntas antes de publicarse.
Cómo medimosTambién medido
37,5 M
filas en 25 s
De bronze a gold con tareas SQL de Lakeflow dentro de un warehouse 2X-Small de Databricks, con linaje.
47 / 47
validaciones superadas
Forge llevando un entorno Oracle de pruebas a AlloyDB: tablas, procedimientos, vistas, un trigger y jobs.
Un banco de trabajo
De una pregunta a un pipeline, en el mismo sitio
Los mismos permisos, el mismo historial y los mismos modelos en todo lo que tu equipo hace con datos.
Conversaciones que enseñan cómo llegaron a la respuesta
Pregunta con tus palabras. Qry encuentra las tablas, escribe el SQL para el motor donde viven, lo ejecuta, dibuja el resultado y te explica qué significa. Cuando el SQL no basta, escribe y ejecuta Python.
- La consulta, las tablas y cada paso, a un clic
- Vuelve a cualquier punto de una conversación y toma otro camino
- Comparte una respuesta con un enlace, hasta donde la compartiste
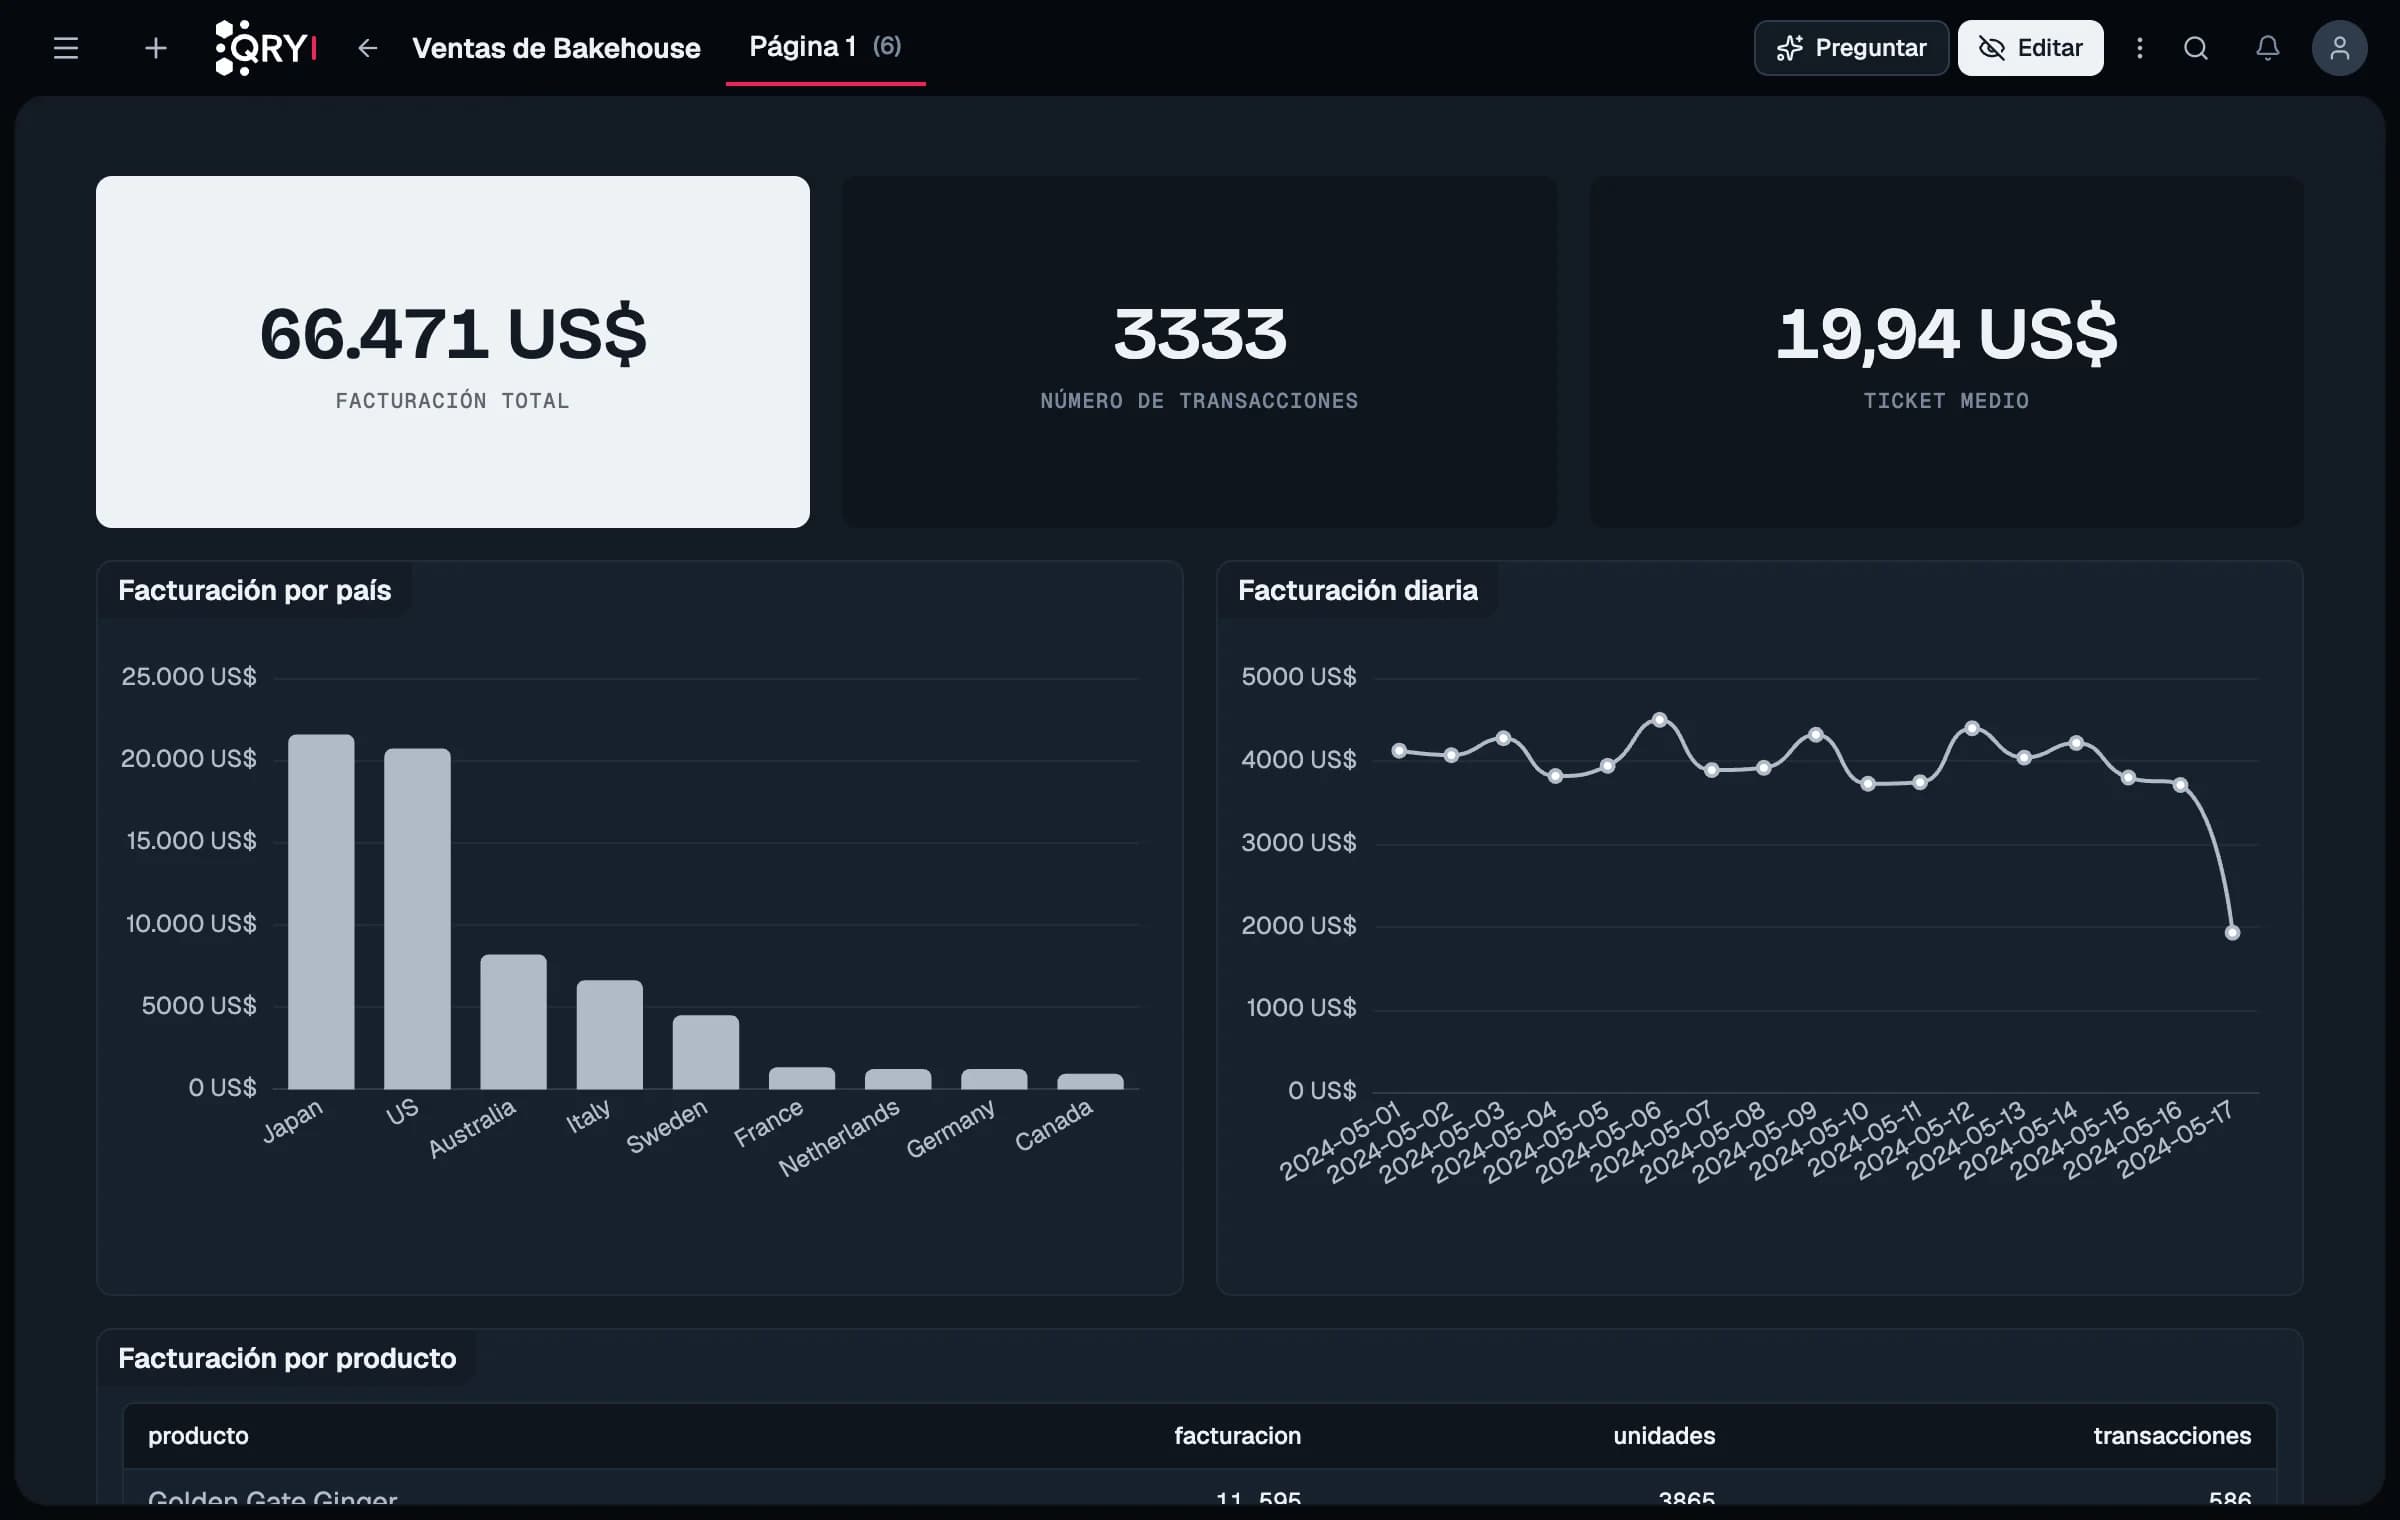
Dashboards a los que puedes preguntar
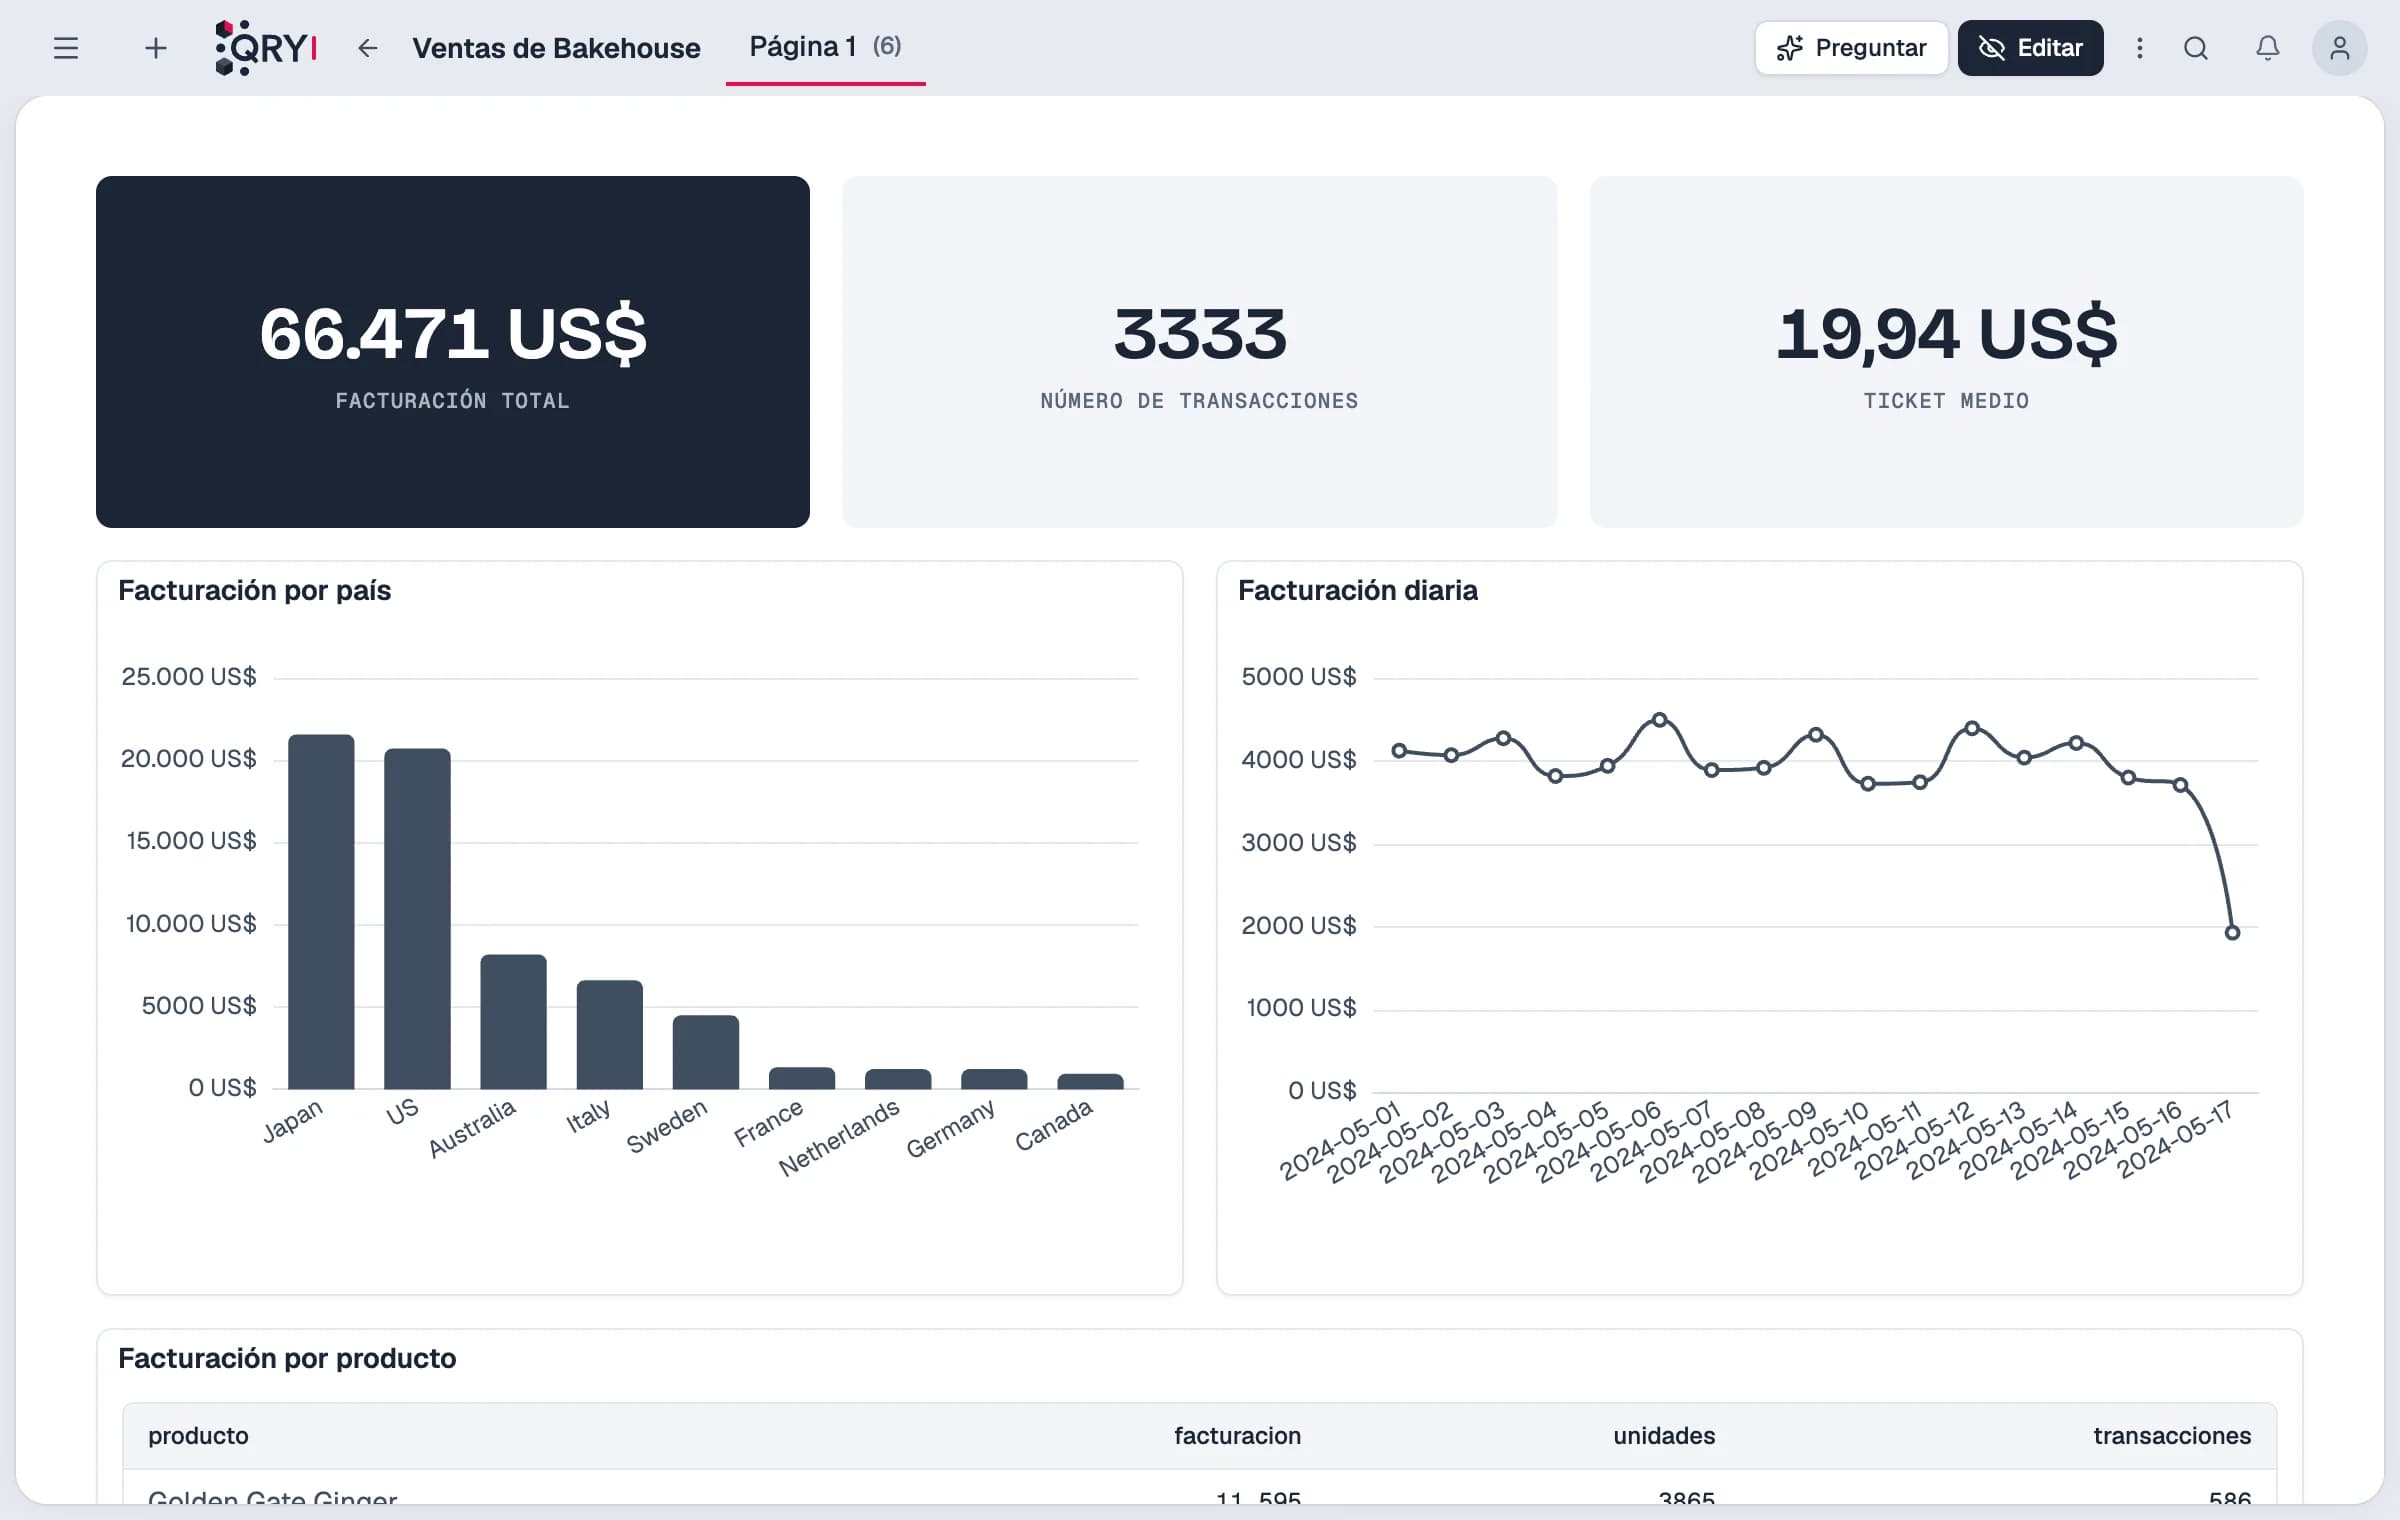
Pide un dashboard y afínalo. Profundiza en los datos, compara periodos, proyecta una serie, detecta anomalías… y pregunta por lo que tienes en pantalla.
- «Explícame esto» en cualquier tile y preguntas sobre toda la página
- Exportación a CSV o Excel y enlaces públicos
- Puntos de control, deshacer e importación entre instalaciones
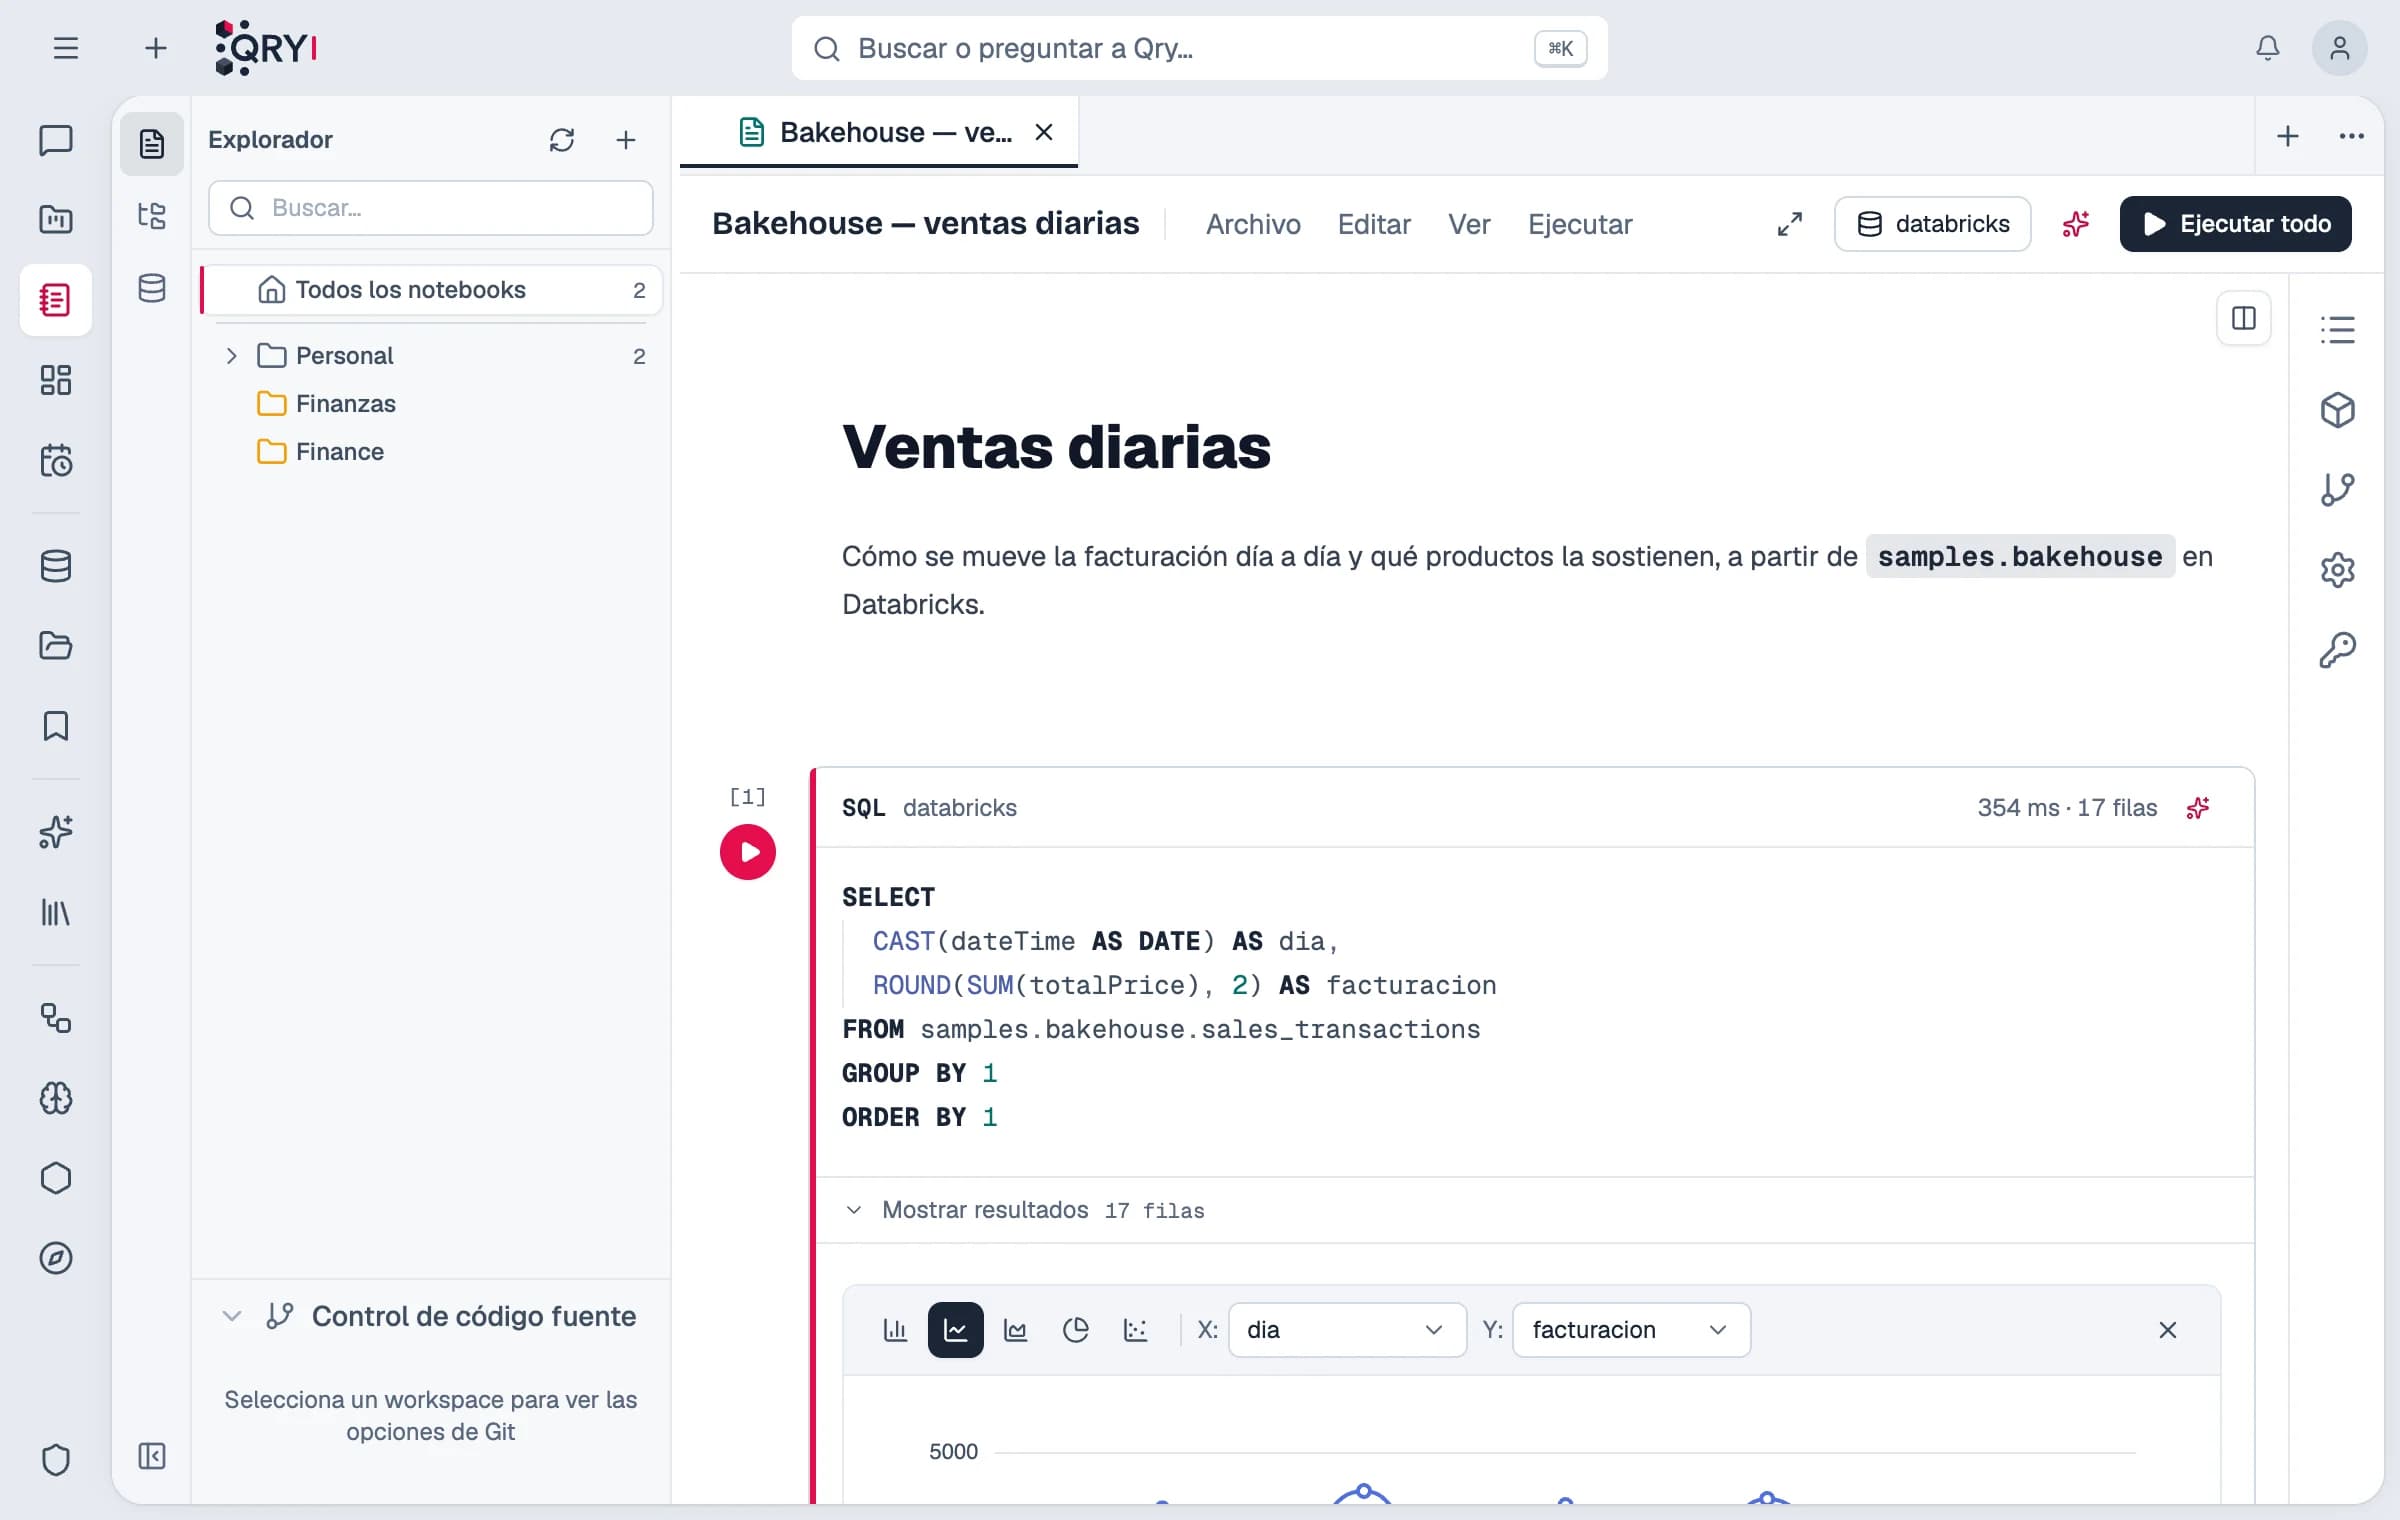
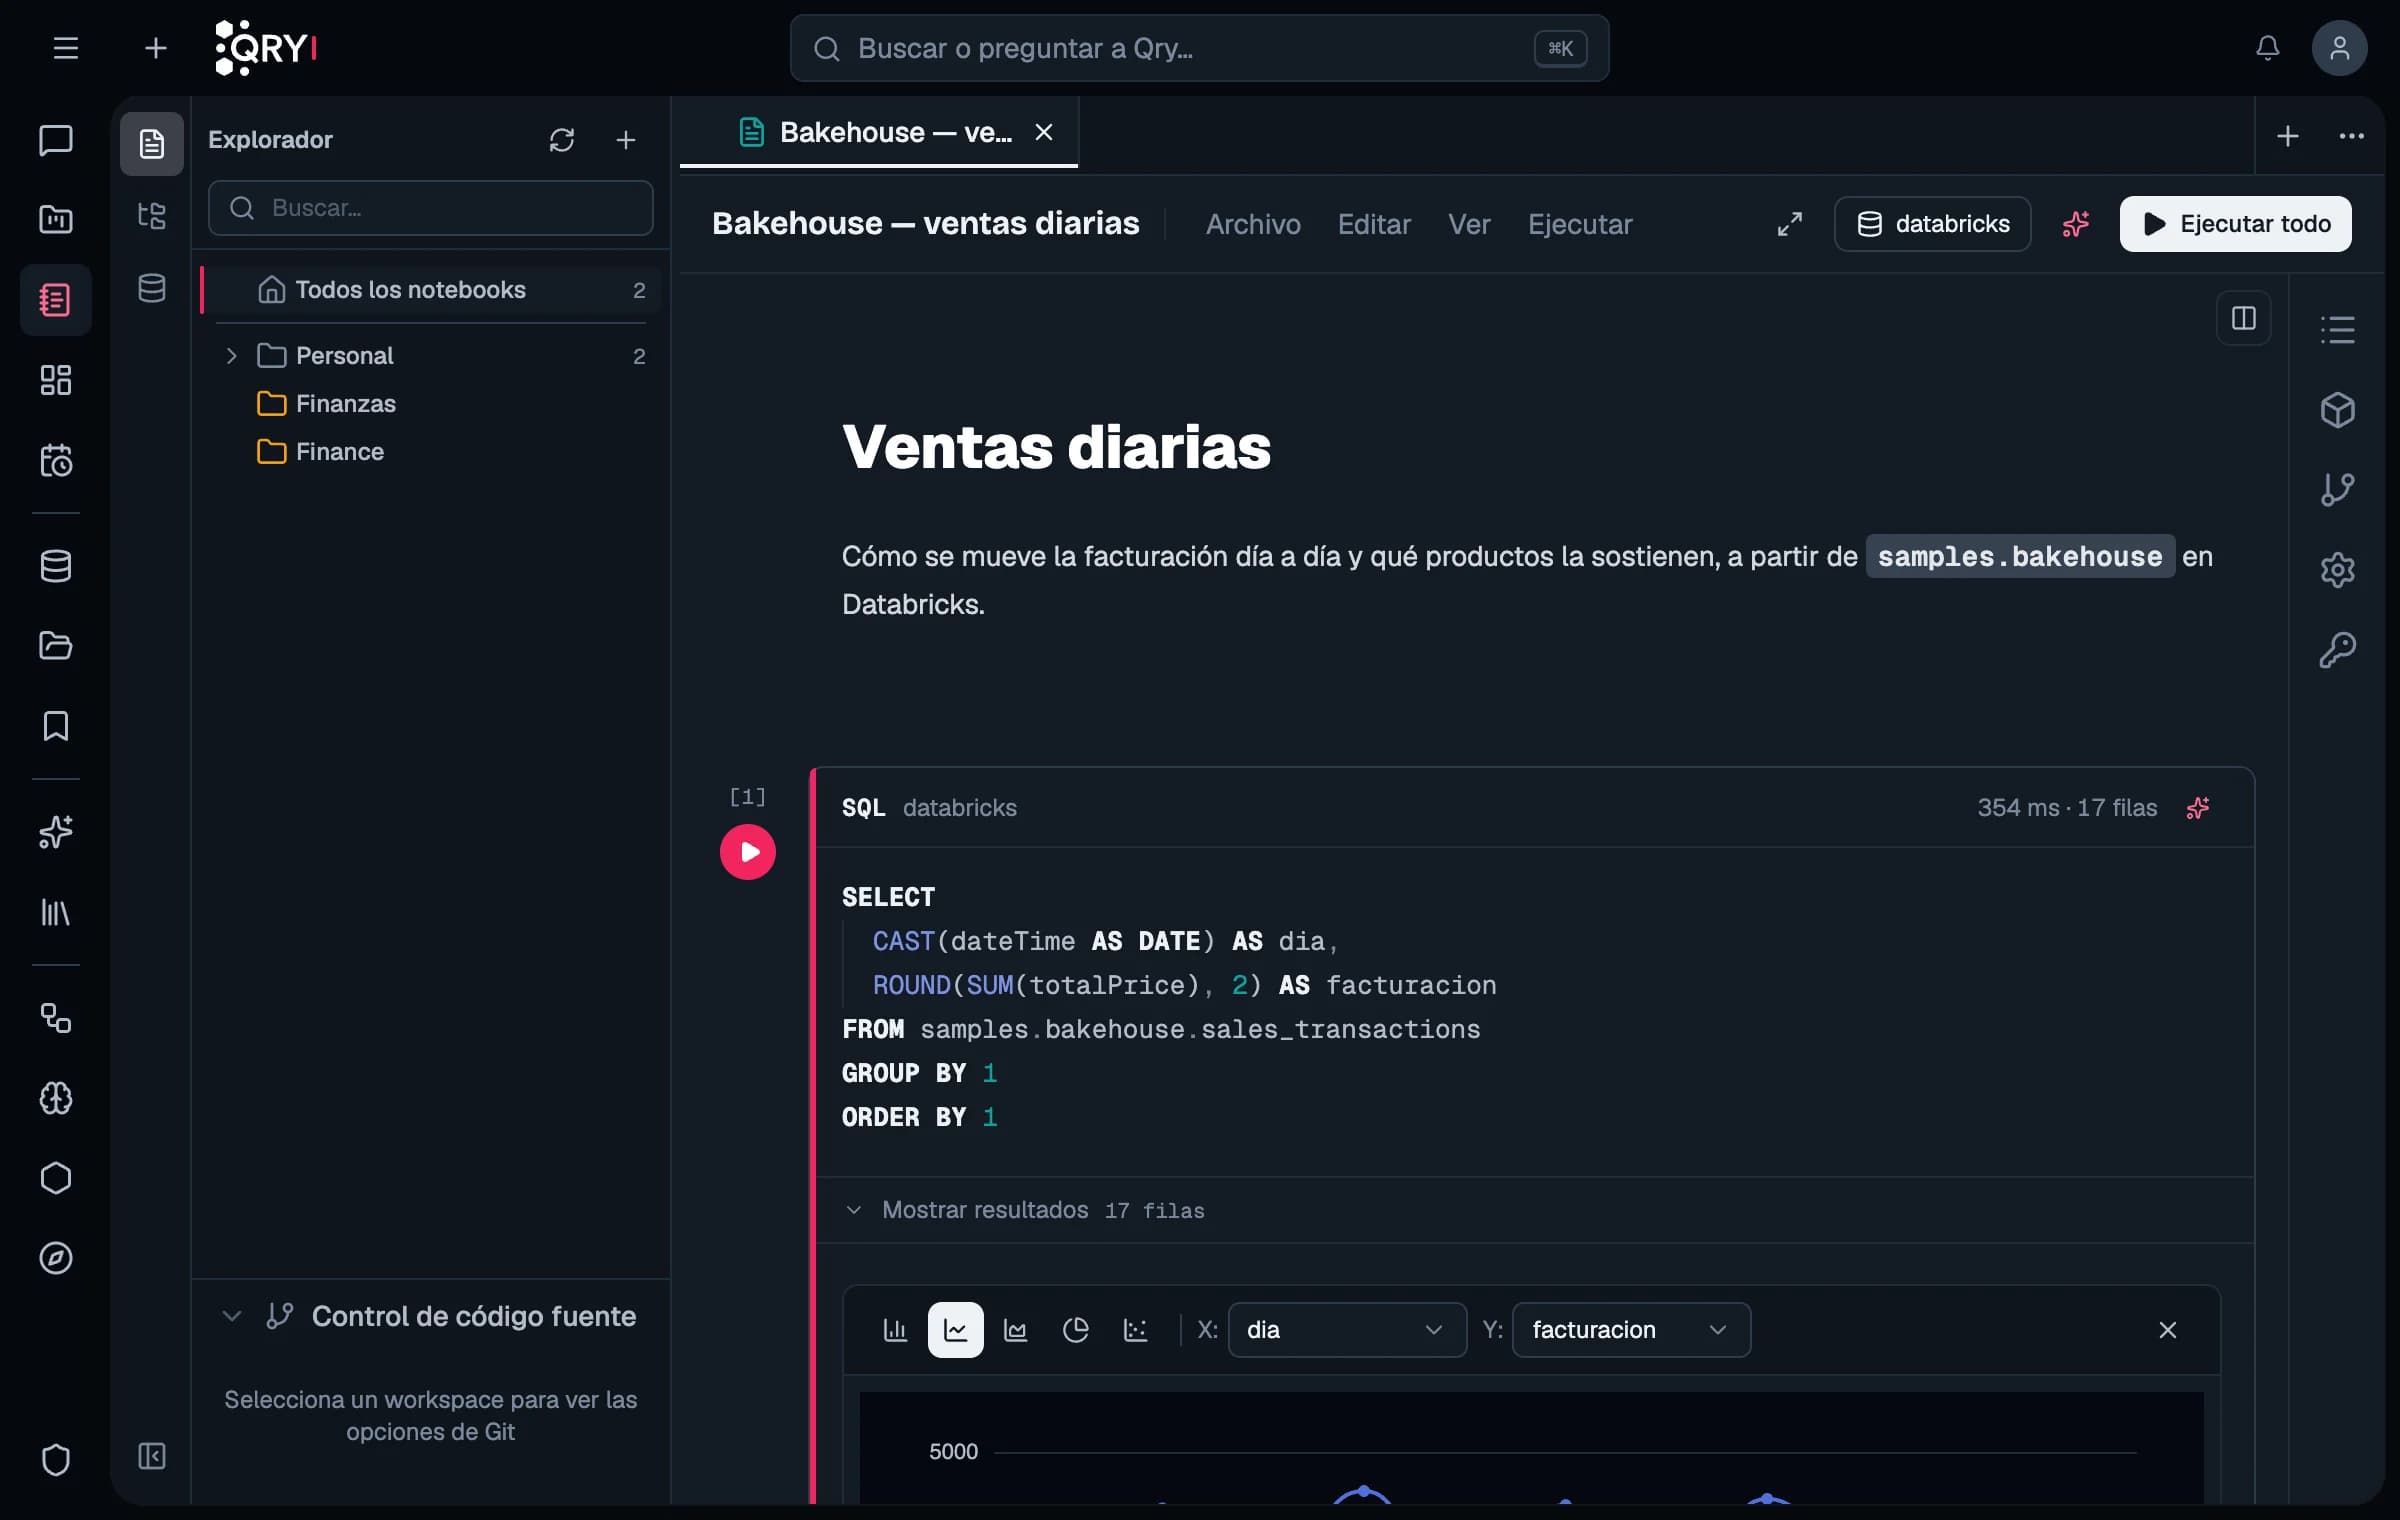
Notebooks para SQL, Python y Spark
Celdas de SQL, Python y PySpark (las de Spark, en tu propio clúster), con los secretos fuera del código. Programa un notebook y cada ejecución tendrá su propio entorno limpio.
- IA que escribe celdas y arregla las que fallan
- Versionados en Git, con fusión celda a celda
- Ejecuciones programadas con variables como {{yesterday}}
Workspaces que conocen tu negocio
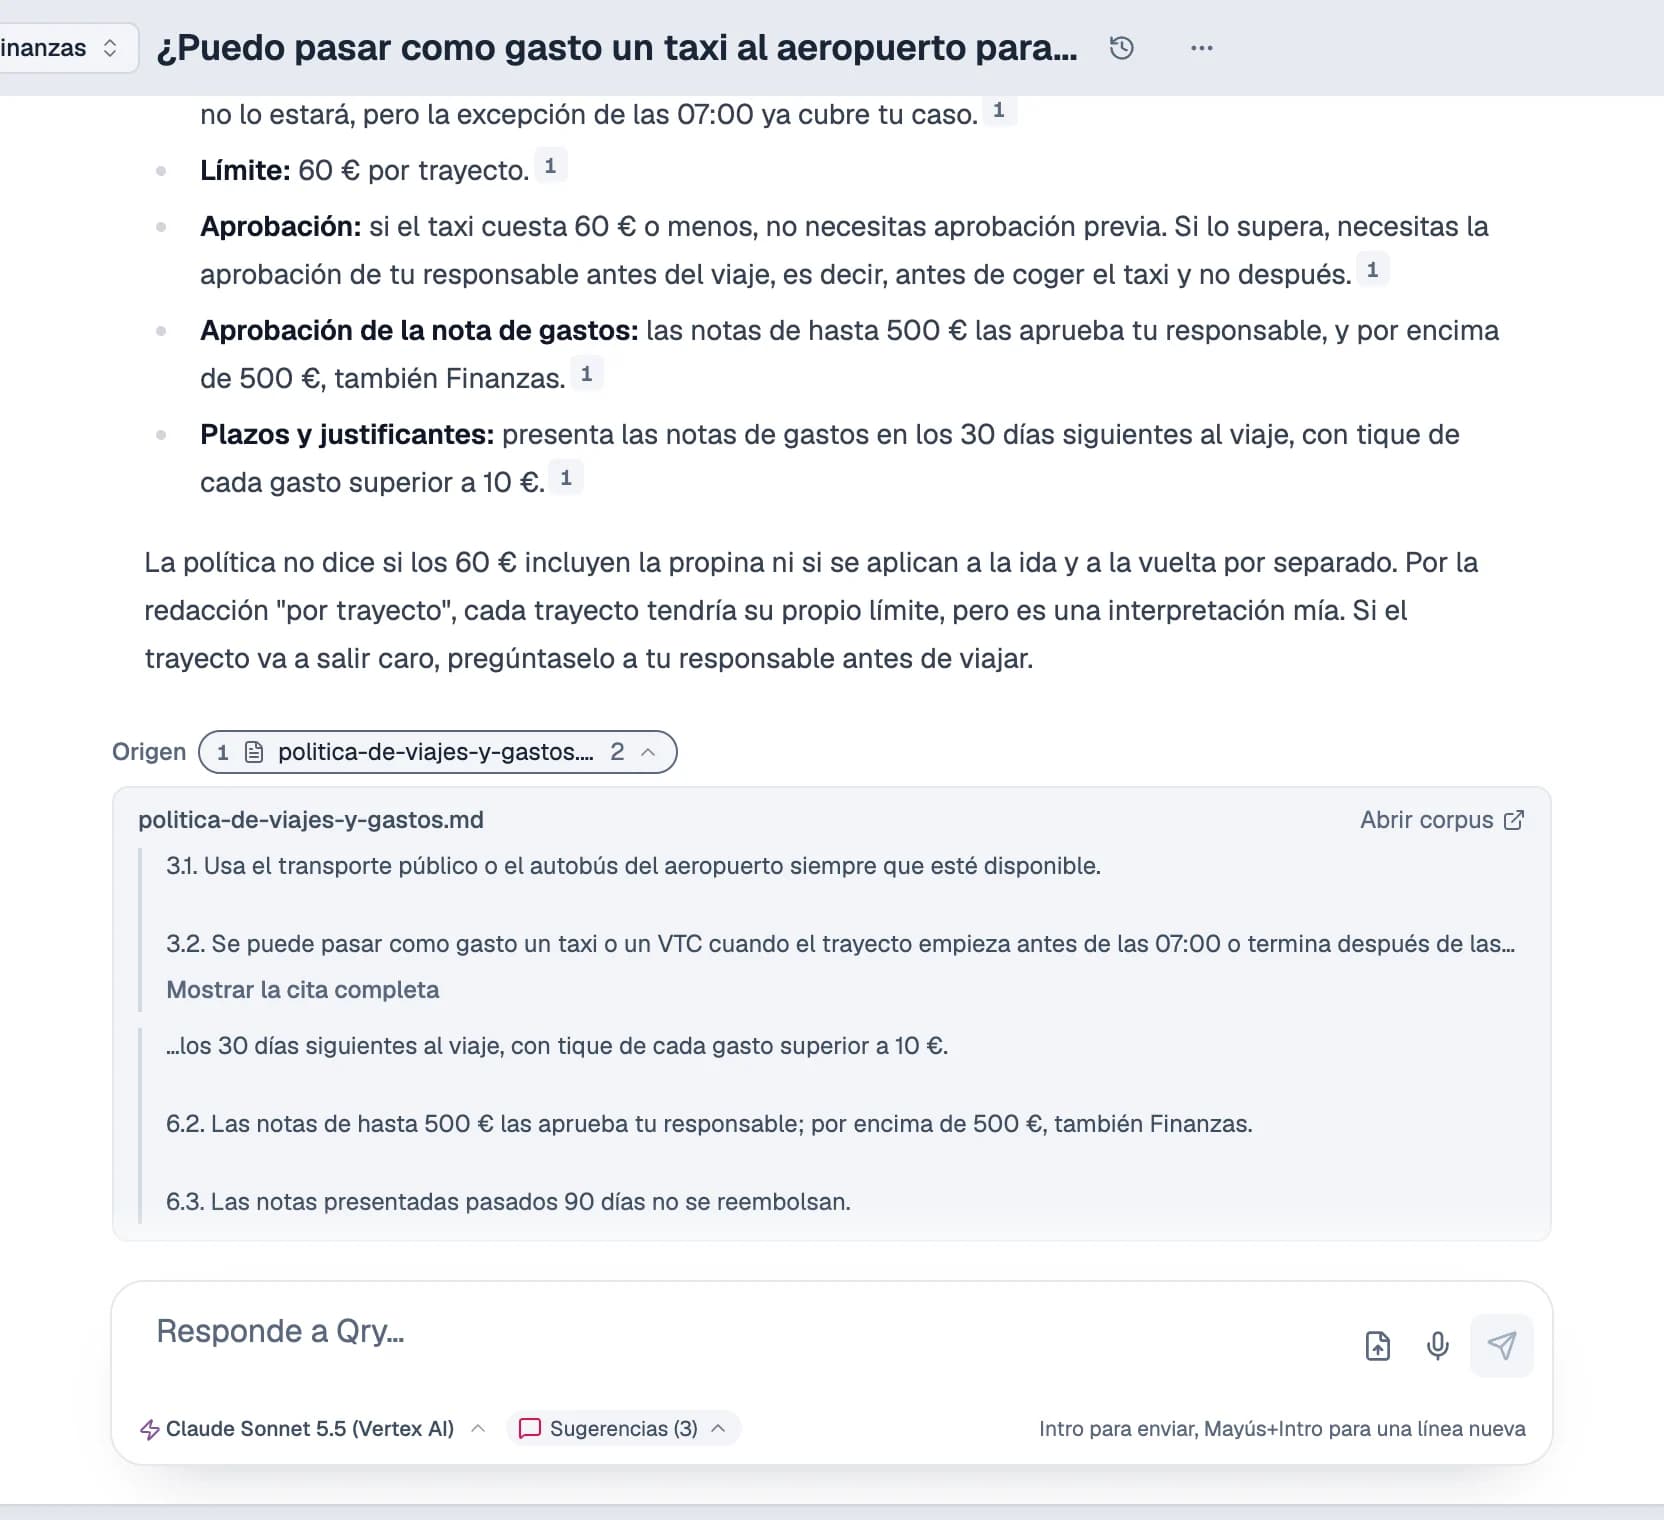
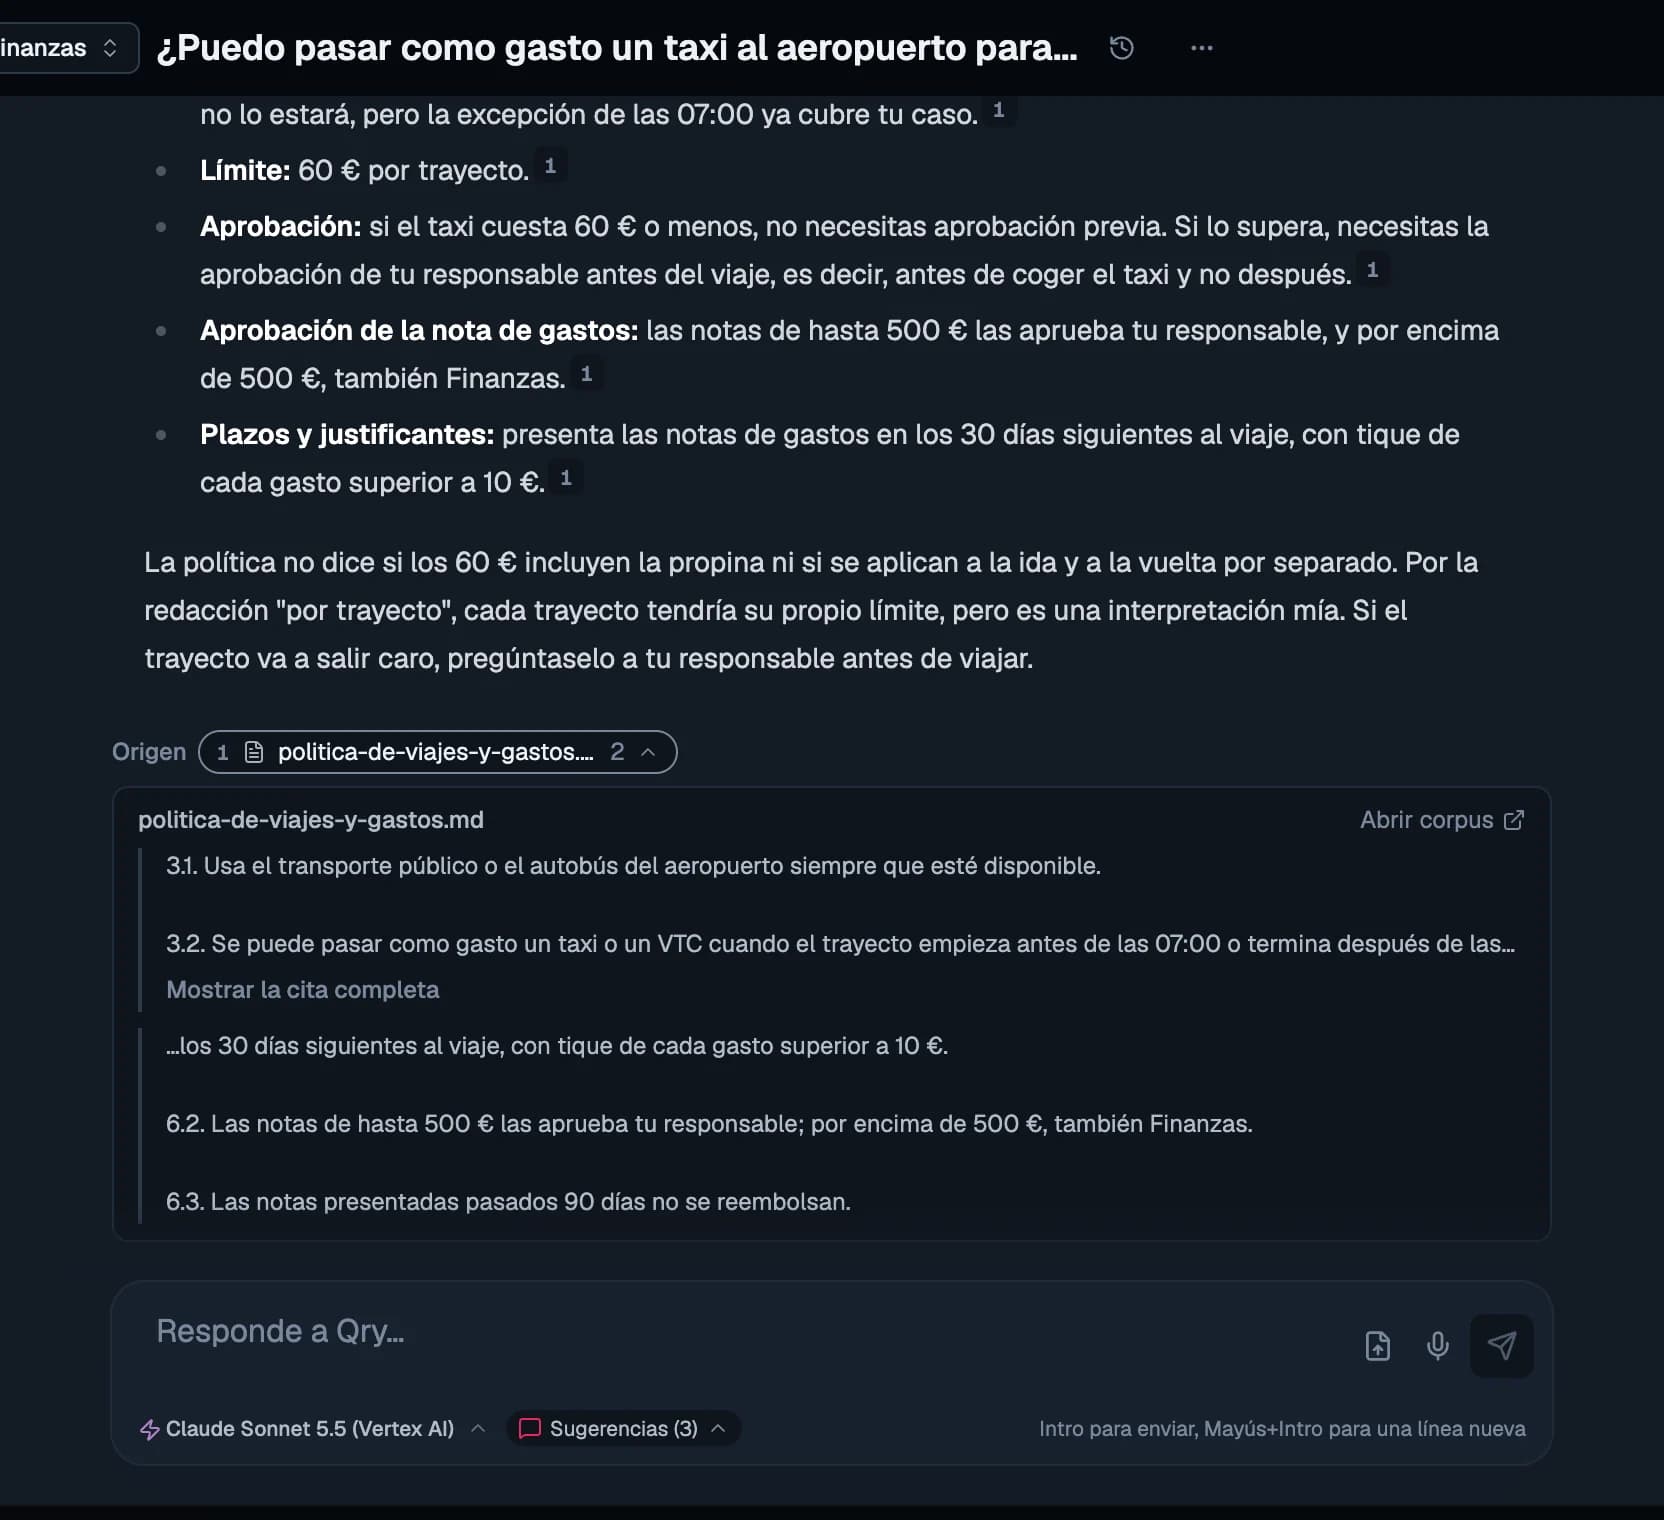
Sube tus documentos a un workspace y pregunta sobre ellos. La búsqueda entiende el sentido y también el término exacto que escribiste, y las respuestas citan el fragmento que usaron. Las Skills enseñan a Qry las reglas de tu negocio, y te avisan cuando una deja de cuadrar con los datos.
- Citas que abren el documento en el fragmento citado
- Conversaciones, archivos y memoria compartidos por equipo
- Reglas por ámbito: empresa, fuente de datos, equipo o persona
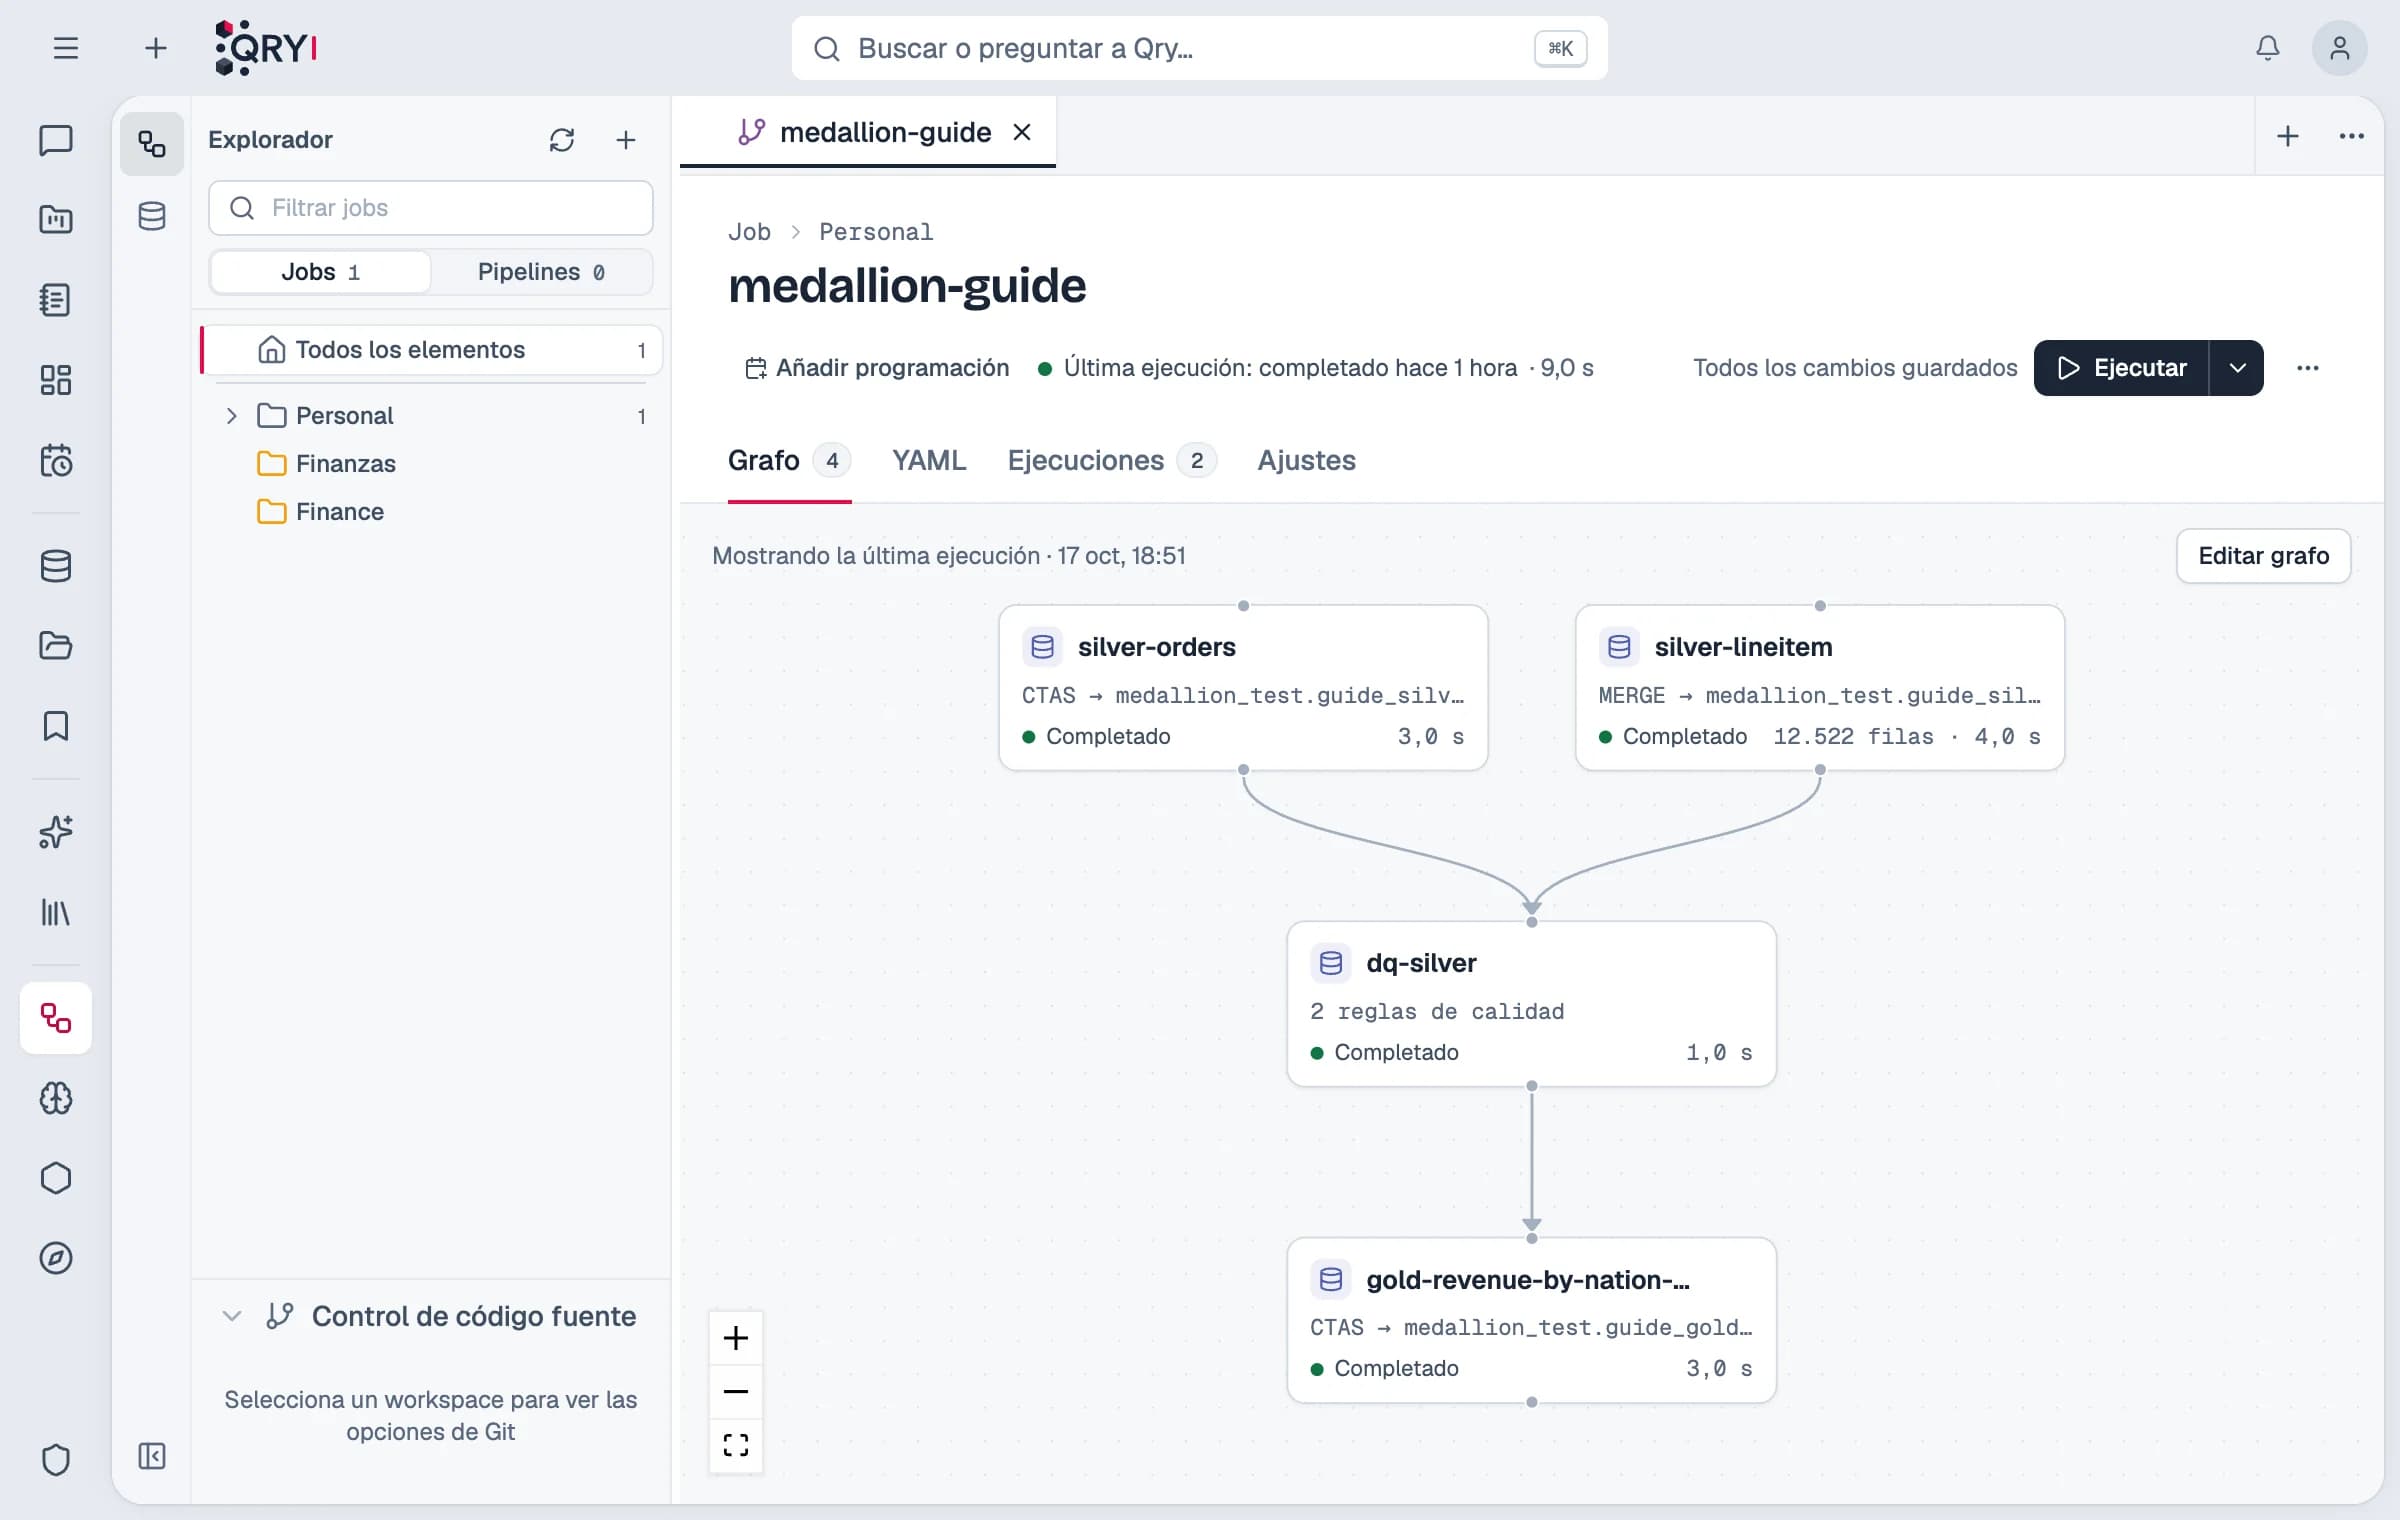
Pipelines que se ejecutan en tu motor
Lakeflow construye las capas bronze, silver y gold con SQL que se ejecuta dentro de tu almacén de datos (nada pasa por Qry), con controles de calidad que detienen la cadena y un linaje que tu catálogo sabe leer.
- Jobs como grafo o como YAML, guardados tal como los escribiste
- Ejecución bajo demanda o programada, con parámetros en cada ejecución
- Las ejecuciones colgadas se cierran y las tablas que dejan de cargarse se señalan solas
Gobierno desde el diseño
Qry actúa como la persona que pregunta
El modelo nunca elige con qué permisos trabaja. Cada consulta de una conversación pasa por la misma comprobación que el catálogo (rol, atributos, filtros de fila), y lo que no se puede comprobar no se muestra.
Permisos de la fuente de datos a la tabla
Usuarios y grupos reciben acceso a una fuente de datos, un catálogo, un esquema o una sola tabla. En SAP HANA, también por módulo.
Filtros de fila por atributo
Etiqueta las tablas, escribe la política una vez («solo mi región», «solo mi empresa») y Qry la aplica a cada consulta que las toque.
Inicio de sesión único
Microsoft Entra ID o Google, con los grupos del directorio asociados a grupos de Qry.
Ante la duda, cierra
La búsqueda, el catálogo y los metadatos ocultan lo que no pueden verificar, en lugar de mostrarlo.
Qry comprueba cada consulta contra tus permisos, pero el techo lo sigue poniendo la cuenta de base de datos con la que se conecta. Te recomendamos cuentas de solo lectura.
Cómo trata Qry la seguridadSoberana
Tu nube, tus modelos, tus reglas
Tu instalación
Gestionada por IXEN o dentro de tu propio Google Cloud, Microsoft Azure o Kubernetes. En ambos casos, cada organización tiene su propia instalación y su propia base de datos.
Tus contratos con los modelos
Claude, GPT y Gemini a través de tu cuenta de Anthropic, Azure AI Foundry, Google Vertex AI u OpenAI: las peticiones quedan bajo contratos que ya tienes. Y cualquier endpoint compatible con OpenAI para los modelos que alojes tú.
Tu gente
Interfaz en español e inglés, hecha con el nivel AA de WCAG 2.2. Presupuestos y cuotas por usuario y grupo, para que el gasto tenga dueño.
IXEN, la empresa que construye y opera Qry, está certificada en la categoría ALTA del Esquema Nacional de Seguridad (ENS).
Qué se ejecuta dónde, y qué saleConectores
Conecta lo que ya tienes
Conectores nativos, que cada usuario recorre con sus propios permisos. Además, archivos y servidores MCP.
- BigQueryAlmacenes y lakehouses
- DatabricksAlmacenes y lakehouses
- SnowflakeAlmacenes y lakehouses
- Amazon RedshiftAlmacenes y lakehouses
- Arrow Flight SQLAlmacenes y lakehouses
- OracleBases de datos
- SAP HANABases de datos
- SQL ServerBases de datos
- PostgreSQLBases de datos
- TeradataBases de datos
- Starburst / TrinoMotores, aplicaciones y streams
- Cloudera ImpalaMotores, aplicaciones y streams
- SalesforceMotores, aplicaciones y streams
- Apache KafkaMotores, aplicaciones y streams
- Archivos y MCPAdemás: CSV, Excel, PDF y servidores MCP
Oracle hasta la versión 9i, a través de tu propio clúster de Spark. Y con Trino o Starburst, todo lo que alcance tu clúster.
Para quién
Un banco de trabajo, dos tipos de equipo
Migración
¿Dejas Oracle, Teradata o SQL Server?
Forge migra el código, no solo las tablas (procedimientos, vistas, funciones, triggers y jobs del planificador), y demuestra el resultado ejecutando los dos lados y comparándolos.
- objetos migrados
- 34 / 34
- validaciones superadas
- 47 / 47
Nuestro entorno Oracle de pruebas, migrado con oleadas automáticas.
Migración con ForgeUn procedimiento de Oracle traducido a BigQuery: el primer despliegue se rechaza porque BigQuery no tiene SELECT … INTO; Forge lo repara a partir del error y lo despliega en 1,1 segundos.
Míralo con tus propios datos
Conectamos Qry a un conjunto de datos que elijas y te lo enseñamos funcionando: una hora y sin diapositivas.